NVIDIA GPU Server
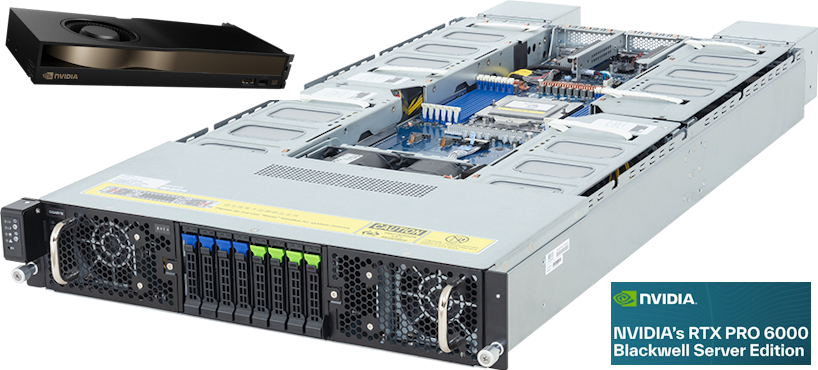
- NVIDIA RTX 6000 Blackwell Pro oder vergleichbare Plattform
- AMD EPYC oder Ryzen Pro Enterprise-CPU-Plattform
- DDR5 ECC Arbeitsspeicher und schneller NVMe-Storage
- Ideal für AI-Inferenz, Visualisierung und produktive GPU-Workloads
- Geeignet für Dual-GPU- und größere AI-Node-Konfigurationen
- Optimiert für LLM-Training, HPC und GPU-Compute-Workloads
- Enterprise-Netzwerk-, Backup- und Firewall-Optionen
- Ausgelegt für skalierbare AI-Infrastrukturen
Dedizierte NVIDIA GPU-Server für AI- und Compute-Workloads
Ein dedizierter NVIDIA GPU-Server bietet exklusiven Zugriff auf physische GPU-Ressourcen, CPU-Leistung, Arbeitsspeicher und Storage. Das ist ein wesentlicher Vorteil für AI-Hosting, Machine-Learning-Pipelines, Large-Language-Model-Workloads, 3D-Rendering, CAD-Anwendungen und wissenschaftliche Compute-Jobs, die stabilen Durchsatz und direkten Hardwarezugriff benötigen.
Im Unterschied zu geteilten Cloud-GPU-Umgebungen ist dediziertes GPU-Hosting von menkiSys auf planbare Performance, isolierte Hardware-Ressourcen und Enterprise-taugliche Betriebsstabilität ausgelegt. Dadurch eignen sich diese Systeme ideal für produktive Business-AI- und High-Performance-Computing-Projekte.
AI-Hosting für LLM, Deep Learning, Inferenz und HPC
NVIDIA GPU-Server Hosting eignet sich besonders für Künstliche Intelligenz (AI), Deep Learning, neuronales Netztraining, Large Language Models (LLM), LLM-Inferenz, generative AI, Chatbots, Computer Vision, wissenschaftliche Simulationen und High Performance Computing (HPC). Moderne GPU-Architekturen ermöglichen massive parallele Rechenoperationen, die für datenintensive Machine-Learning-Workloads entscheidend sind. Mit leistungsstarken NVIDIA-Beschleunigerplattformen wie der NVIDIA RTX 6000 Blackwell Pro (96 GB), RTX 5090, H100 oder H200 können Unternehmen AI-Projekte deutlich effizienter betreiben als auf klassischer CPU-only-Infrastruktur. Diese GPUs sind speziell für AI-Training, LLM-Workloads, Deep-Learning-Modelle, GPU-Rendering und komplexe Datenanalysen optimiert und bieten enorme Speicherbandbreite sowie hohe Rechenleistung für moderne AI-Frameworks wie PyTorch, TensorFlow oder CUDA-basierte Anwendungen. Gerade für Unternehmen, Forschungsprojekte und AI-Startups, die mit generativer KI, Transformer-Modellen oder großen neuronalen Netzen arbeiten, sind dedizierte NVIDIA GPU-Server ein entscheidender Performance-Faktor. Workloads wie LLM-Training, AI-Inference-Cluster, Computer-Vision-Pipelines, Data-Science-Plattformen oder GPU-beschleunigte Simulationssysteme profitieren massiv von dedizierten AI-Servern mit NVIDIA Blackwell RTX 6000 Pro oder anderen High-End-GPU-Architekturen. Diese Systeme ermöglichen es, große Datenmengen parallel zu verarbeiten, Trainingszeiten zu verkürzen und komplexe Modelle wesentlich schneller produktiv einzusetzen. Ob Ihr Use Case Modellentwicklung, Inferenz-Pipelines, Data Science, GPU-Rendering, wissenschaftliche Simulation oder Enterprise-Analytics ist: menkiSys bietet skalierbares GPU-Server-Hosting aus Österreich mit professionellem Support und dedizierter Rechenzentrumsumgebung. Unsere Infrastruktur unterstützt sowohl Single-GPU-Server als auch Multi-GPU-Konfigurationen und AI-Cluster für anspruchsvolle Enterprise-Workloads. Durch dedizierte Bare-Metal-GPU-Server mit NVIDIA Blackwell RTX 6000 Pro, optimierter NVMe-Storage-Performance, ECC-Arbeitsspeicher und redundanter Glasfaseranbindung erhalten Unternehmen eine stabile und leistungsstarke Plattform für moderne AI-Infrastruktur, LLM-Hosting und GPU-beschleunigte Hochleistungsanwendungen.
Ob Ihr Use Case Modellentwicklung, Inferenz-Pipelines, Data Science, Rendering oder Enterprise-Analytics ist: menkiSys bietet skalierbares GPU-Server-Hosting aus Österreich mit professionellem Support und dedizierter Rechenzentrumsumgebung.
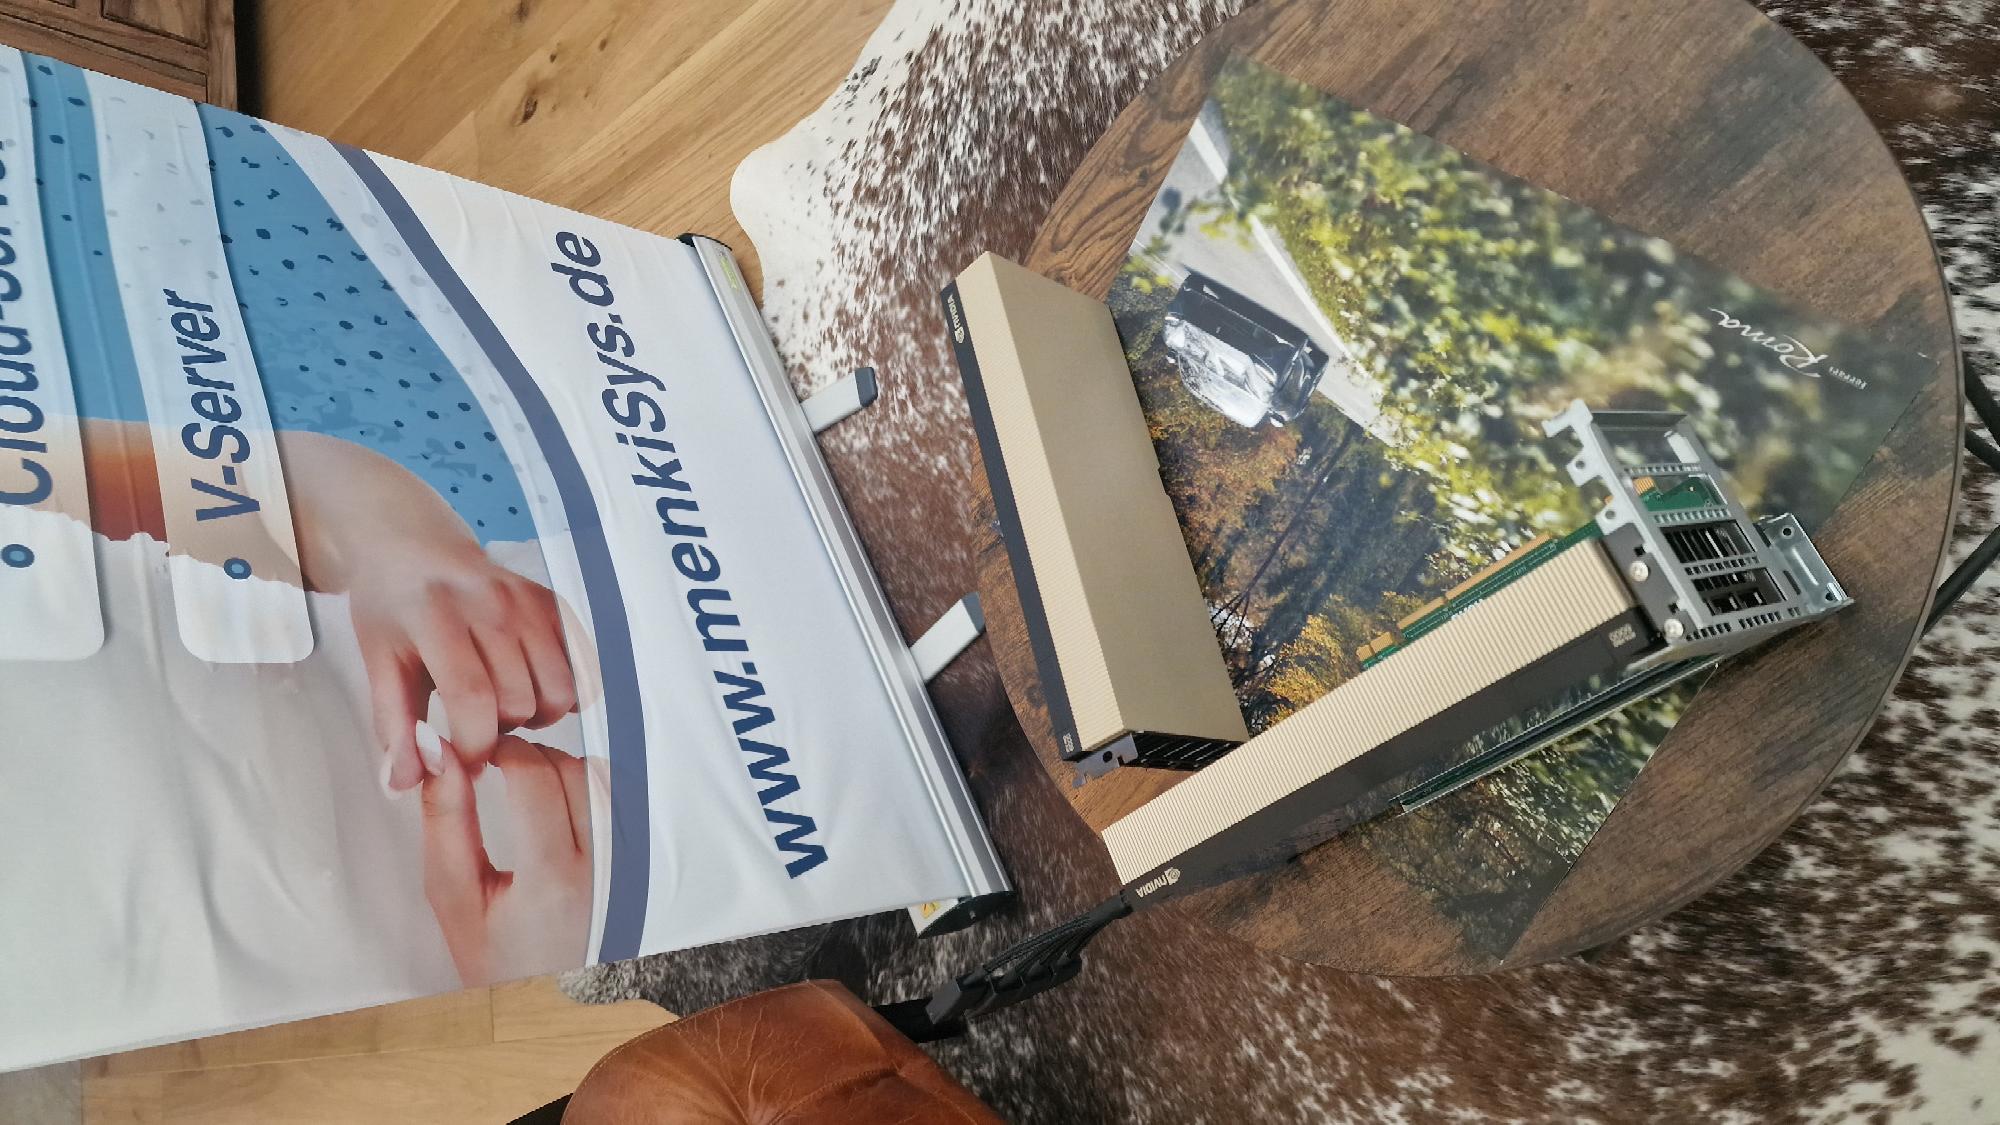
NVIDIA B300 GPU-Server mieten – Blackwell Ultra für KI in Österreich
Sie möchten große KI-Modelle auf dedizierter Hardware betreiben und suchen einen Ansprechpartner in Österreich? Mit einer NVIDIA HGX B300 Serverlösung richtet sich menkiSys an Unternehmen, KI-Start-ups und Forschungsteams mit anspruchsvollen Anforderungen an Rechenleistung, GPU-Speicher und parallele Verarbeitung. Im Mittelpunkt stehen produktive Large Language Models, generative KI und langfristig planbare AI-Infrastrukturen. Für Ihr B300-Projekt stimmen wir Hardwareausstattung, Betriebsmodell und Bereitstellung individuell mit Ihnen ab.
Die HGX-B300-Plattform verbindet acht NVIDIA Blackwell Ultra GPUs über NVLink und NVSwitch der fünften Generation. HBM3e-GPU-Speicher und schnelle Verbindungen zwischen den Beschleunigern bilden die technische Grundlage für anspruchsvolle Multi-GPU-Anwendungen. So lässt sich eine dedizierte KI-Umgebung aufbauen, in der Modellbetrieb, Datenverarbeitung und Entwicklungsprozesse aufeinander abgestimmt werden.
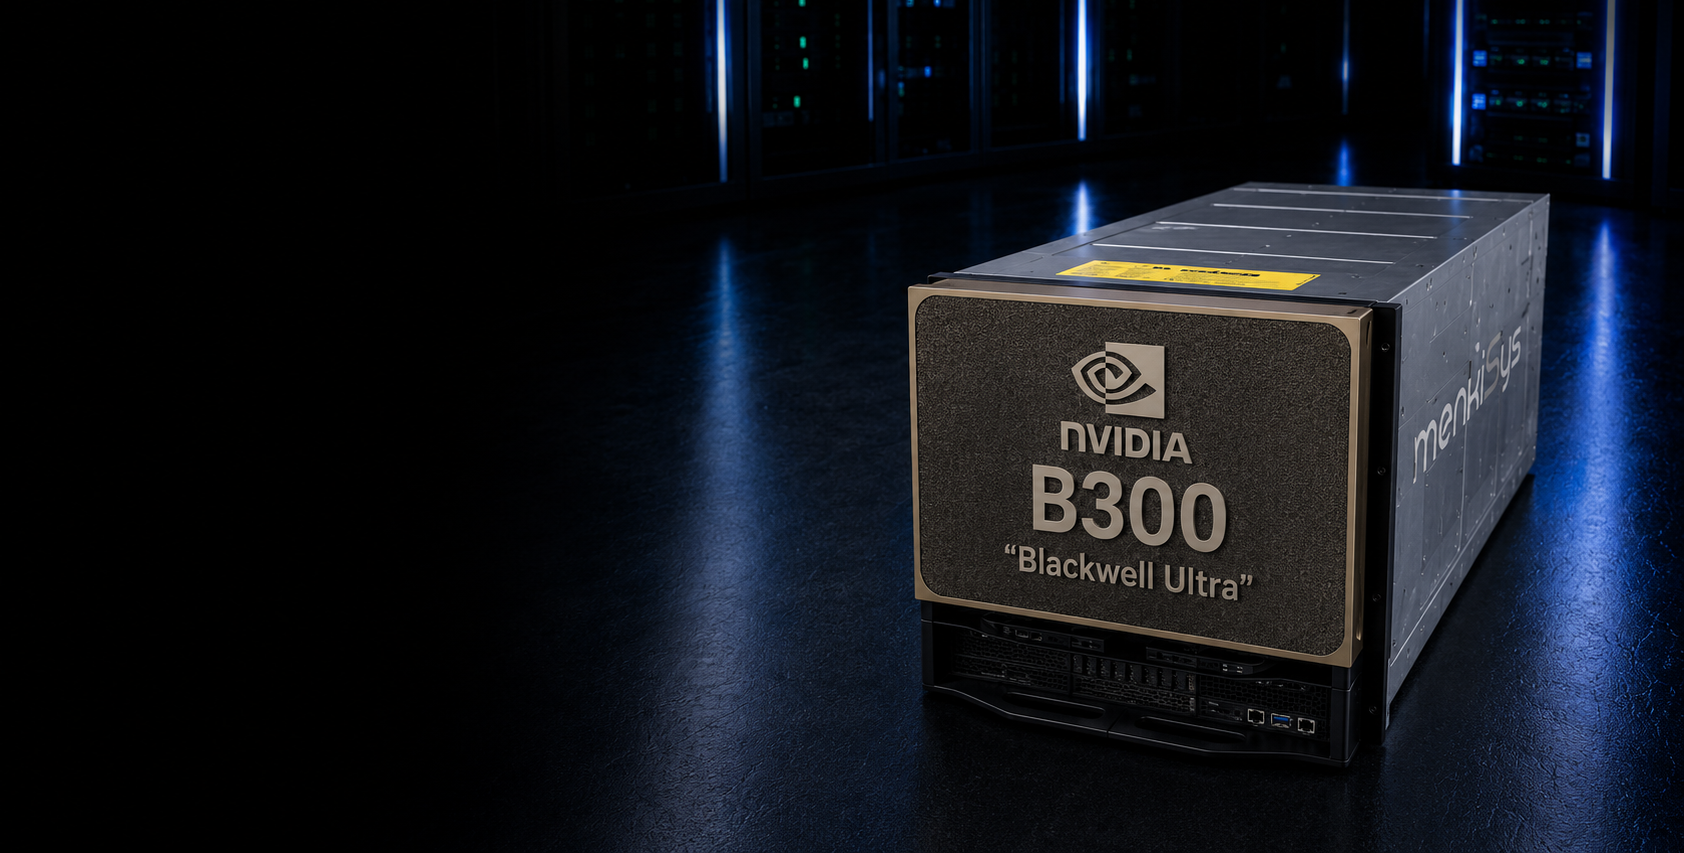
LLM-Inferenz, Reasoning und generative KI auf NVIDIA B300
Ein NVIDIA B300 KI-Server kommt insbesondere dann in Betracht, wenn große Sprachmodelle, umfangreiche Kontexte oder viele gleichzeitige Anfragen die vorhandene Infrastruktur auslasten. Mögliche Einsatzbereiche sind interne KI-Assistenten, automatisierte Dokumentenverarbeitung, Wissenssuche, Code-Assistenten und multimodale Anwendungen. Bei der Planung zählen neben der Modellgröße auch Antwortzeiten, erwartete Nutzerzahlen und die Länge der erzeugten Antworten. Daraus ergibt sich, welche Ressourcen für einen verlässlichen Produktivbetrieb erforderlich sind.
Für Retrieval-Augmented Generation (RAG) werden zusätzlich Dokumentenspeicher, Embedding-Verarbeitung und die Suchkomponente berücksichtigt. Die GPU übernimmt dabei die jeweils beschleunigbaren Modellberechnungen; die Qualität der Antworten hängt ebenso von Datenbasis, Retrieval und Anwendung ab. Bei Reasoning-Modellen ist außerdem ausreichend Kapazität für längere Berechnungsschritte einzuplanen. So entsteht eine Infrastruktur, die sich am tatsächlichen Geschäftsprozess orientiert.
Fine-Tuning, Deep Learning und verteiltes Modelltraining
Neben Inferenz lässt sich eine B300-Umgebung für die Anpassung und Weiterentwicklung von KI-Modellen planen. Dazu gehören Fine-Tuning mit unternehmenseigenen Datensätzen, Experimente mit neuronalen Netzen und verteilte Trainingsläufe. Ob ein vollständiges Training, ein parameter-effizientes Verfahren oder eine kleinere GPU-Konfiguration sinnvoll ist, hängt vom Modell, den Daten und dem Projektbudget ab. Ein klar definiertes Trainingsziel erleichtert die Auswahl der passenden Serverressourcen.
Für Multi-GPU-Workloads müssen Software und Modellparallelisierung zur Hardware passen. Der Speicher mehrerer GPUs wird einer Anwendung nicht automatisch als ein einziger frei nutzbarer Speicher bereitgestellt. Framework, Verteilung der Modellgewichte, Zwischenergebnisse und Kommunikationsaufwand bestimmen gemeinsam die nutzbare Kapazität. Deshalb werden auch Treiber, CUDA-Version und die eingesetzte Trainings- oder Inferenzsoftware bei der Projektplanung berücksichtigt.
Dediziertes B300 Hosting im Rechenzentrum Österreich
Für Unternehmen mit klaren Standortanforderungen bietet menkiSys einen direkten Ansprechpartner für GPU-Server-Hosting in Österreich. Für ein B300-Projekt im Rechenzentrum Marchtrenk in Oberösterreich werden Serverstandort, Zugriffswege und Leistungsumfang im Angebot festgelegt. Eine dedizierte Bereitstellung ermöglicht die exklusive Nutzung der vereinbarten Hardware und schafft eine nachvollziehbare Grundlage für Kapazitätsplanung und interne Betriebsprozesse.
Netzwerkanbindung, Storage, Datensicherung und Betreuung sollten von Beginn an zum KI-Projekt passen. Große Trainingsdatensätze benötigen andere Datenpfade als ein interner Chatbot mit moderatem Anfragevolumen. Ebenso unterscheiden sich Anforderungen an Wiederherstellung, Wartungsfenster und administrative Zugriffe. menkiSys stimmt diese Punkte mit Ihnen ab, damit aus leistungsfähiger GPU-Hardware eine für Ihren Betrieb passende Serverlösung wird.
NVIDIA HGX B300 oder RTX PRO: Welche GPU-Plattform passt?
Nicht jedes KI-Projekt benötigt ein System mit acht B300-GPUs. Für kleinere Modelle, Entwicklung, Visualisierung oder einzelne Inferenzdienste kann ein dedizierter NVIDIA RTX PRO 6000 GPU-Server die wirtschaftlichere Wahl sein. NVIDIA HGX B300 wird interessant, wenn der Workload von einer eng gekoppelten Multi-GPU-Plattform profitiert. Entscheidend ist die Leistung Ihrer konkreten Anwendung bei passendem Ressourcenverbrauch.
NVIDIA B300 Server mieten: Konfiguration und Angebot
Für ein passendes Angebot nennen Sie uns Ihr KI-Modell beziehungsweise Ihre Anwendung, die gewünschte Nutzung für Training oder Inferenz, den voraussichtlichen Speicherbedarf und Ihren Zieltermin. Auch Datenvolumen, gleichzeitige Nutzer und gewünschte Vertragslaufzeit helfen bei der Dimensionierung. Preis, konkrete Ausstattung und Verfügbarkeit werden projektbezogen bestätigt. So erhalten Sie eine belastbare Entscheidungsgrundlage für Ihren NVIDIA B300 GPU-Server bei menkiSys.

Enterprise-GPU-Infrastruktur aus einem privaten österreichischen Rechenzentrum
Enterprise-GPU-Infrastruktur aus einem familiengeführten privaten Rechenzentrum in Österreich menkiSys betreibt seine GPU- und Serverinfrastruktur als familiengeführtes Unternehmen aus Österreich. Im Gegensatz zu anonymen Großanbietern oder internationalen Cloud-Konzernen setzt menkiSys auf eine persönlich geführte Unternehmensstruktur mit direkter technischer Verantwortung, kurzen Entscheidungswegen und langfristiger Kundenbetreuung. Die gesamte Infrastruktur wird in einem eigenen Rechenzentrum in Oberösterreich betrieben und kontinuierlich weiterentwickelt. Durch diese Struktur profitieren Unternehmen von einer stabilen Enterprise-GPU-Infrastruktur, klaren Betriebsprozessen und direktem Zugang zu technischen Ansprechpartnern. Besonders bei komplexen AI-Workloads, GPU-Clustern, HPC-Projekten oder Large-Language-Model-Infrastrukturen ist eine verlässliche Betreuung entscheidend. menkiSys kombiniert moderne NVIDIA GPU-Technologien – darunter RTX 6000 Blackwell Pro, RTX 5090, H100, H200 und kommende B200 AI-Beschleuniger – mit dedizierter Serverhardware, redundanter Netzwerkarchitektur und professionellen Datacenter-Standards. Als familiengeführtes Hosting-Unternehmen legt menkiSys großen Wert auf langfristige Partnerschaften, technische Transparenz und nachhaltige Infrastrukturentwicklung. Kunden erhalten dadurch nicht nur leistungsstarke GPU-Server, sondern eine stabile Hosting-Plattform für AI, Deep Learning, HPC, Simulation und datenintensive Unternehmensanwendungen.
Dadurch eignen sich menkiSys GPU-Server besonders für Enterprise-AI-Projekte, Agenturplattformen, gemanagte Kundenlösungen, Simulations-Workloads und dedizierte Compute-Services, die mehr benötigen als anonymes Massenmarkt-Cloud-Hosting.
NVIDIA GPU-Server erklärt
Zentrale technische und wirtschaftliche Fragen zu dedizierten AI-GPU-Servern, Enterprise-GPU-Hosting und produktiven NVIDIA-Workloads
-
Ein NVIDIA GPU-Server ist ein dedizierter Hochleistungsserver mit professioneller GPU-Beschleunigerhardware. Diese Systeme sind für Künstliche Intelligenz, Machine Learning, LLM-Workloads, Rendering, Simulation und rechenintensive Business-Anwendungen ausgelegt.
-
Maximale Rechenleistung: optimiert für KI, Deep Learning, LLM und HPC.
Skalierbarkeit: von Single-GPU-Systemen bis zu größeren dedizierten GPU-Umgebungen.
Enterprise-Stabilität: dedizierte Hardware ohne Shared-Cloud-Konkurrenz auf Ressourcenebene.
Professioneller Betrieb: geeignet für produktive Business-Workloads und langfristige Infrastrukturplanung.
-
Typische Workloads sind Large Language Models, AI-Inferenz, Deep Learning, Computer Vision, GPU-Rendering, Simulation, Forschungs-Workloads, Data Science und High-Performance Computing.
-
menkiSys betreibt ein privates österreichisches Rechenzentrum mit starkem Fokus auf Enterprise-Hosting, direkte Betreuung, schnelle Reaktionszeiten und maßgeschneiderte Infrastrukturlösungen. Statt anonymem Massenhosting erhalten Kunden projektorientierten Support und eine technisch kontrollierte Umgebung für produktive GPU-Workloads.
-
Ja. Wir analysieren Ihre geplanten Workloads und empfehlen eine passende GPU-Server-Konfiguration auf Basis von Projektgröße, Speicherbedarf, Rechenintensität und erwarteter Skalierung. Das reicht von Single-GPU-Server-Setups bis zu erweiterten dedizierten AI-Umgebungen.
-
Ja. menkiSys stellt dedizierte NVIDIA GPU-Server in Österreich für Unternehmen, KI-Projekte, Entwickler und professionelle Compute-Workloads bereit. Die Systeme werden im menkiSys Rechenzentrum in Österreich betrieben und können für AI-Inferenz, Large Language Models, Deep Learning, Rendering, Simulation und HPC konfiguriert werden. Ein dedizierter GPU-Server bietet dem Kunden exklusiven Zugriff auf die vereinbarten Hardware-Ressourcen und schafft eine planbare Plattform für produktive Workloads.
-
Ein dedizierter GPU-Server stellt reservierte physische Server-Ressourcen für einen Kunden bereit, während viele GPU-Cloud-Angebote auf virtualisierten oder verbrauchsabhängig abgerechneten Ressourcen basieren. Dedizierte Systeme sind insbesondere interessant, wenn Workloads dauerhaft laufen, planbare Leistung benötigt wird, große Datenbestände permanent auf dem Server verbleiben oder der Kunde direkte Kontrolle über Betriebssystem, Treiber und Software-Stack wünscht. Cloud-Modelle können für kurze oder stark schwankende Workloads sinnvoll sein, während sich dediziertes GPU-Hosting bei langfristigen Produktivumgebungen häufig klarer kalkulieren lässt.
-
Der passende LLM GPU-Server hängt von Modellgröße, Quantisierung, Kontextlänge, Anzahl gleichzeitiger Nutzer sowie davon ab, ob das System für Inferenz, Fine-Tuning oder Training eingesetzt wird. Professionelle RTX-Plattformen können für viele Inferenz- und Entwicklungs-Workloads geeignet sein, während High-End-Multi-GPU-Plattformen wie NVIDIA HGX B300 auf deutlich größere KI-Workloads und Skalierungsanforderungen ausgerichtet sind. menkiSys dimensioniert AI-Server deshalb nach dem tatsächlichen Modell und Anwendungsfall und nicht ausschließlich nach dem Namen der GPU.
-
Der notwendige GPU-VRAM für AI- und LLM-Workloads lässt sich nicht allein anhand der Parameterzahl eines Modells bestimmen. Genauigkeit beziehungsweise Quantisierung, Kontextlänge, KV-Cache, Batch-Größe, Framework-Overhead und gleichzeitige Anfragen beeinflussen den Speicherbedarf. Training und Fine-Tuning können zusätzlich deutlich mehr Speicher als reine Inferenz erfordern. menkiSys betrachtet deshalb das geplante Modell, den Software-Stack und das erwartete Nutzungsmuster, bevor eine GPU-Server-Konfiguration empfohlen wird.
-
Ein NVIDIA HGX B300 Server wird interessant, wenn ein KI-Projekt eine eng integrierte Multi-GPU-Plattform für sehr große Modelle, anspruchsvolle Inferenzdienste, Modelltraining, Fine-Tuning oder andere High-Performance-AI-Workloads benötigt. Entscheidend ist, ob die Anwendung mehrere High-End-GPUs und die dazugehörige Systemarchitektur tatsächlich ausnutzen kann. Für kleinere Projekte kann ein professioneller Single-GPU- oder Dual-GPU-Server wirtschaftlicher sein. menkiSys vergleicht deshalb zuerst die Anforderungen des Workloads, bevor die Plattform ausgewählt wird.
-
Ja. Ein professioneller NVIDIA RTX PRO GPU-Server kann eine leistungsfähige Plattform für AI-Inferenz, Entwicklungsumgebungen, Visualisierung, Rendering, Computer Vision und viele Business-AI-Anwendungen sein. Er ist häufig eine praxisnahe Wahl, wenn ein Projekt dedizierte GPU-Leistung benötigt, aber kein großes HGX-Multi-GPU-System erforderlich ist. CPU-Leistung, Arbeitsspeicher, NVMe-Storage und Netzwerkanbindung sollten dennoch gemeinsam mit der GPU dimensioniert werden, damit die gesamte Serverplattform zum Workload passt.
-
Ja. menkiSys kann Multi-GPU-Server-Konfigurationen für Workloads bereitstellen, die von mehreren NVIDIA GPUs profitieren. Typische Einsatzbereiche sind größere LLM-Inferenzumgebungen, verteiltes Training, Deep Learning, Rendering und wissenschaftliches Computing. Die eingesetzte Software muss eine geeignete Form von Modell-, Tensor- oder Datenparallelisierung unterstützen, da sich der Speicher mehrerer GPUs nicht automatisch wie ein einziger uneingeschränkter Speicherpool verhält. Die Serverarchitektur wird deshalb gemeinsam mit dem vorgesehenen AI-Framework und Workload geplant.
-
Dedizierte NVIDIA GPU-Server können abhängig von gewählter Hardware, Treibern und Anwendung mit gängigen Linux-Distributionen oder geeigneten Windows-Server-Umgebungen betrieben werden. Typische AI-Stacks umfassen NVIDIA-Treiber, CUDA-basierte Frameworks, Container-Umgebungen sowie Inferenz- oder Trainingssoftware. Anwendungen wie PyTorch, TensorFlow, vLLM, Ollama oder individuelle AI-Services können entsprechend den Projektanforderungen eingesetzt beziehungsweise geprüft werden. Die Kompatibilität sollte immer mit der konkreten GPU-Generation und den benötigten Softwareversionen abgestimmt werden.
-
Eine schnelle GPU allein garantiert noch kein schnelles AI-System. NVMe-Storage, System-RAM, CPU-Leistung und Netzwerkbandbreite beeinflussen, wie schnell Datensätze, Modelldateien und Anwendungsdaten zur GPU gelangen. Große Trainingsdatensätze und Modell-Checkpoints können erheblichen Storage- und Netzwerkverkehr erzeugen, während Preprocessing zusätzlich CPU und Arbeitsspeicher belastet. Ein ausgewogen dimensionierter GPU-Server vermeidet deshalb Engpässe außerhalb des Beschleunigers und verbessert die Effizienz der gesamten Infrastruktur.
-
GPU-Server-Hosting in Österreich kann für Unternehmen attraktiv sein, die einen klar definierten Serverstandort, direkte technische Ansprechpartner und eine Infrastruktur in räumlicher Nähe zum eigenen Geschäft wünschen. Ein heimisches Rechenzentrum kann interne Anforderungen an Serverstandort, Zugriffskonzepte und betriebliche Verantwortlichkeiten vereinfachen. menkiSys kombiniert dedizierte NVIDIA GPU-Hardware mit Rechenzentrumsbetrieb in Österreich und projektbezogener Betreuung und eignet sich damit für Unternehmen, die nicht jeden AI-Workload bei einem internationalen Hyperscaler betreiben möchten.
